 TuneFinderDokumentation
Indizes und Titelerkennung · iOS · Android
Titel erkennen und prüfen
Erstelle einen bearbeitbaren Index mit lokaler OCR und prüfe die Vorschläge.
Auf dieser Seite
Was die Erkennung macht
OCR liest gedruckten Text und schlägt Titel/Seitenbereiche vor. Sie läuft lokal und sendet keine PDF an einen OCR-Dienst. Nur geprüfte und gespeicherte Vorschläge werden suchbar. Beginne mit einer importierten PDF. Der Index listet Titel und Seiten getrennt von der PDF.
Titel erkennen
- Öffne Bücher und das Buch.
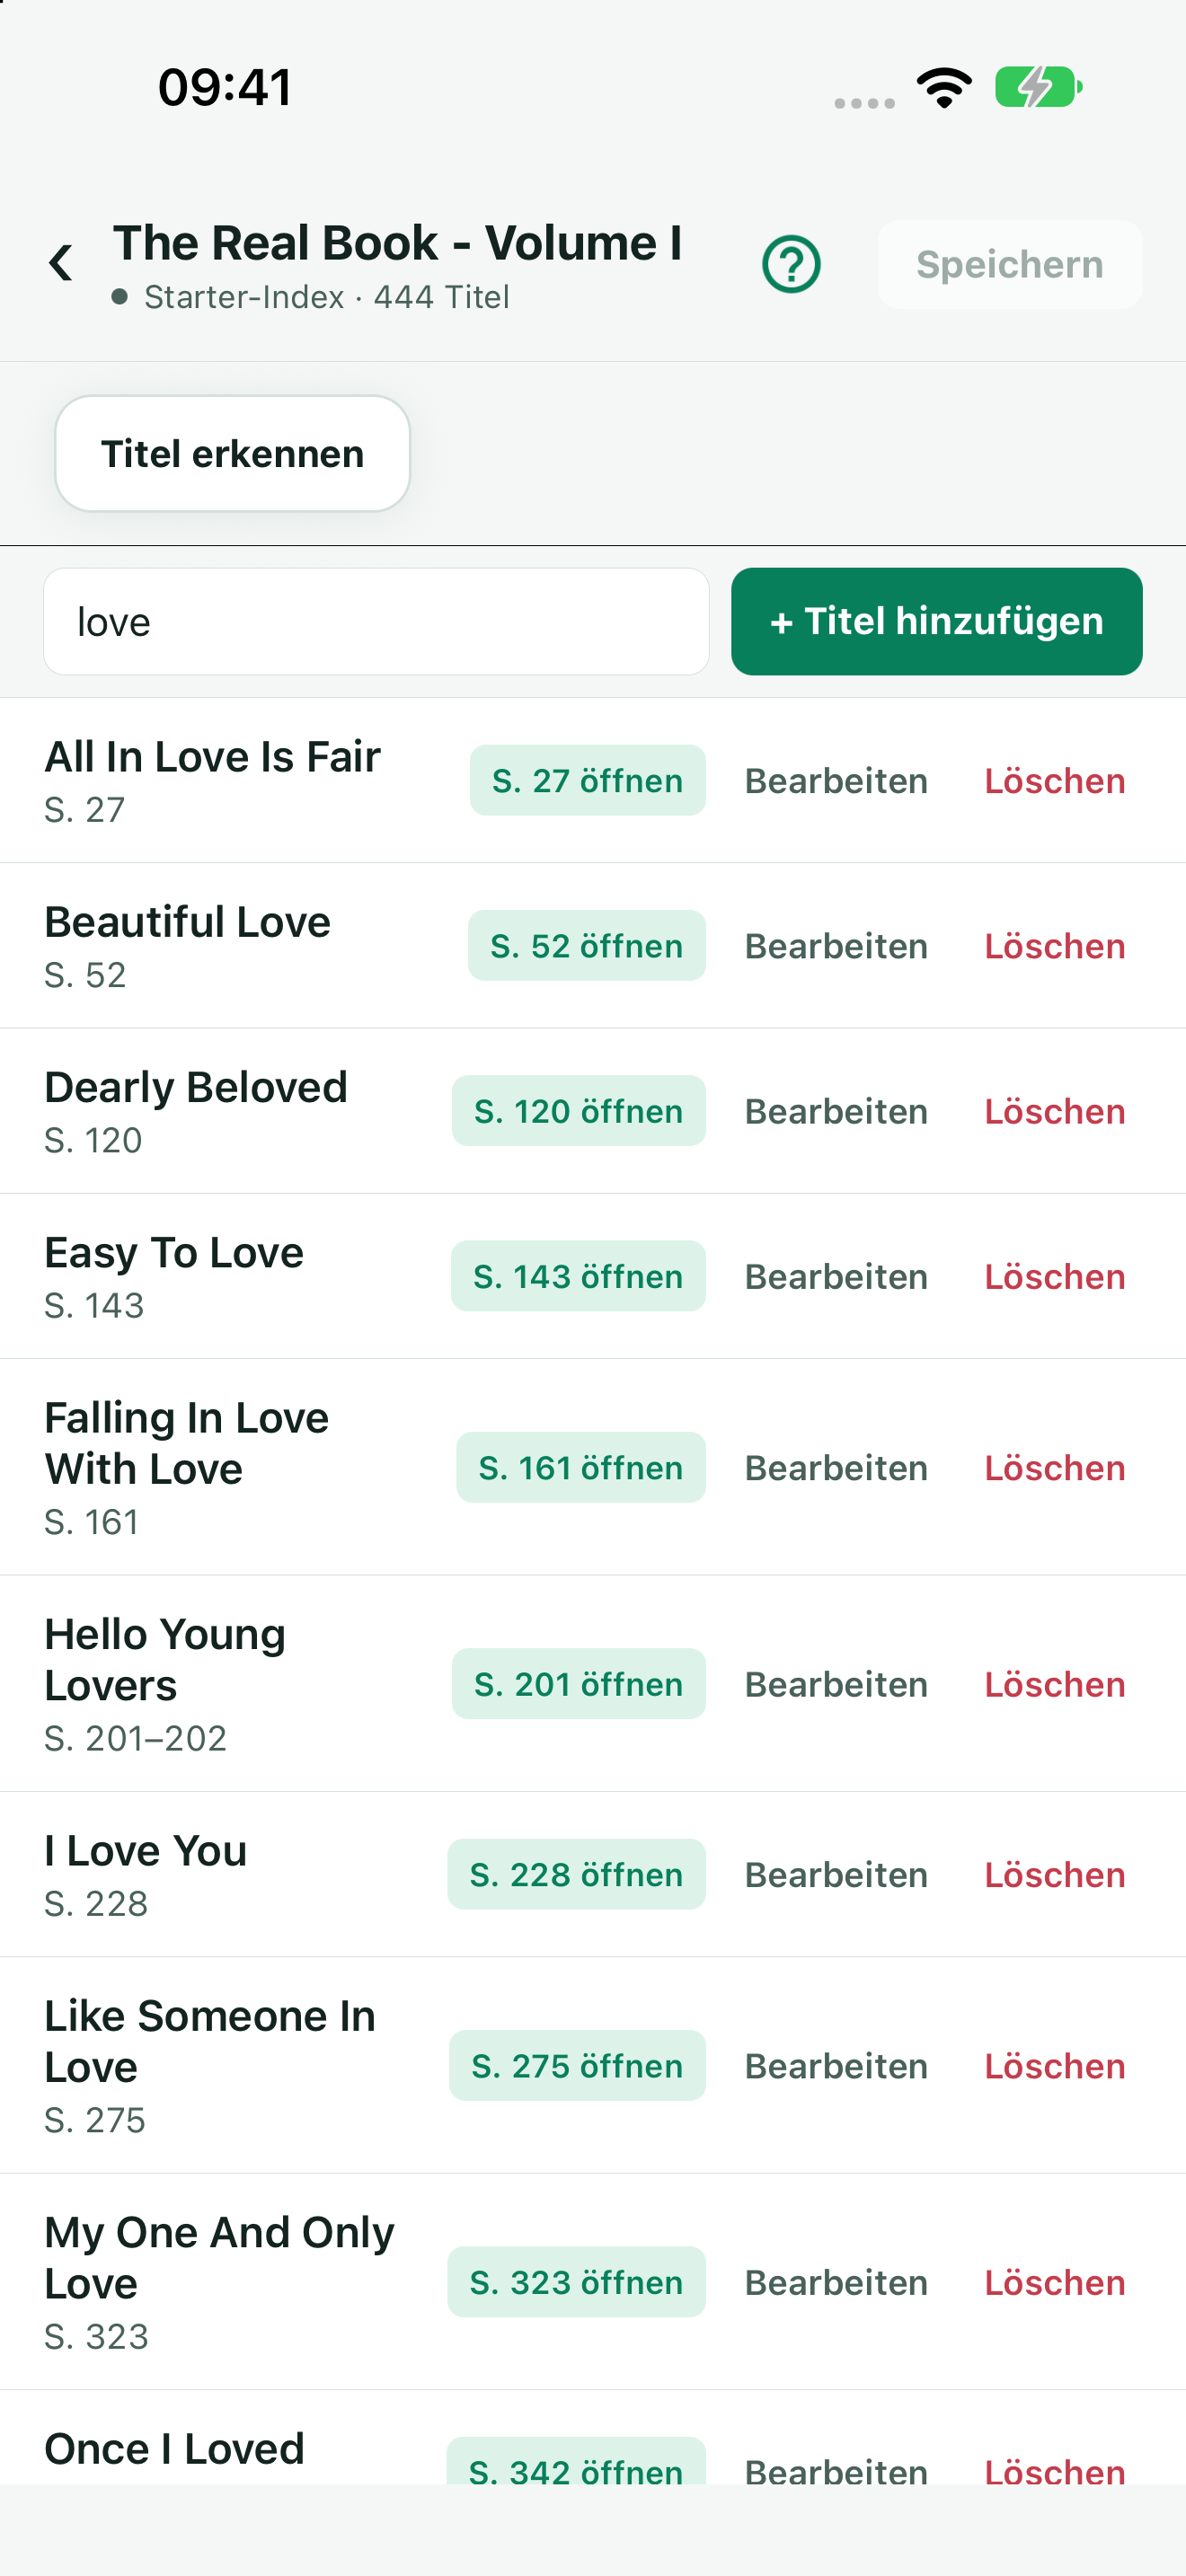
- Tippe auf Titel erkennen; der Editor startet die Erkennung.
- Halte TuneFinder im Vordergrund.
- Prüfe die Einträge nach Abschluss.
Pausieren und fortsetzen
Abbrechen pausiert nach der aktuellen Seite. Hintergrundwechsel unterbricht ebenfalls. PDF und verarbeitete Seiten bleiben; Titel erkennen setzt fort. Speichere oder verwerfe offene Bearbeitungen zuerst. Eine ersetzte PDF kann einen alten Entwurf ungültig machen: generiere einen neuen.
Prüfen und speichern
- Prüfe Titel und erste/letzte Seite.
- Öffne PDF-Seiten im Editor; gedruckte Zahlen können abweichen.
- Korrigiere mit Bearbeiten, Löschen oder Titel hinzufügen.
- Nutze Speichern für den Index.
- Wähle in Details Für die Suche verwenden, falls für kostenlose Suche noch nicht ausgewählt.
Unvollständige Ergebnisse verbessern
Klarer gedruckter lateinischer Text funktioniert am besten. Handschrift, dekorative Schrift, schiefe/blasse Scans, Inhaltsseiten und mehrere Titel pro Seite führen zu Fehlern. Notation allein identifiziert keinen Titel. Prüfe Bereiche: Wiederholte Überschriften können zusammengeführt werden, Fortsetzungen ohne Überschrift brauchen manuelle Korrektur. Ohne erkannte Titel kannst du manuell eintragen; die PDF bleibt.
Neu aufbauen oder wiederherstellen
Nach Indexlöschung kannst du erneut erkennen, solange die PDF verfügbar ist. Stelle sie wieder her oder wähle sie neu. Lösche nicht die Bibliothek zur OCR-Reparatur. Kontaktiere die Hilfe mit Version, Plattform, Aktion und dauerhafter Referenz. Akzeptierte Indizes lassen sich synchronisieren.